Pensa na última vez que você comemorou um número de marketing. Um pico de visitas, um post que andou sozinho, uma semana boa de leads. Agora a pergunta incômoda: quantas daquelas pessoas eram pessoas?
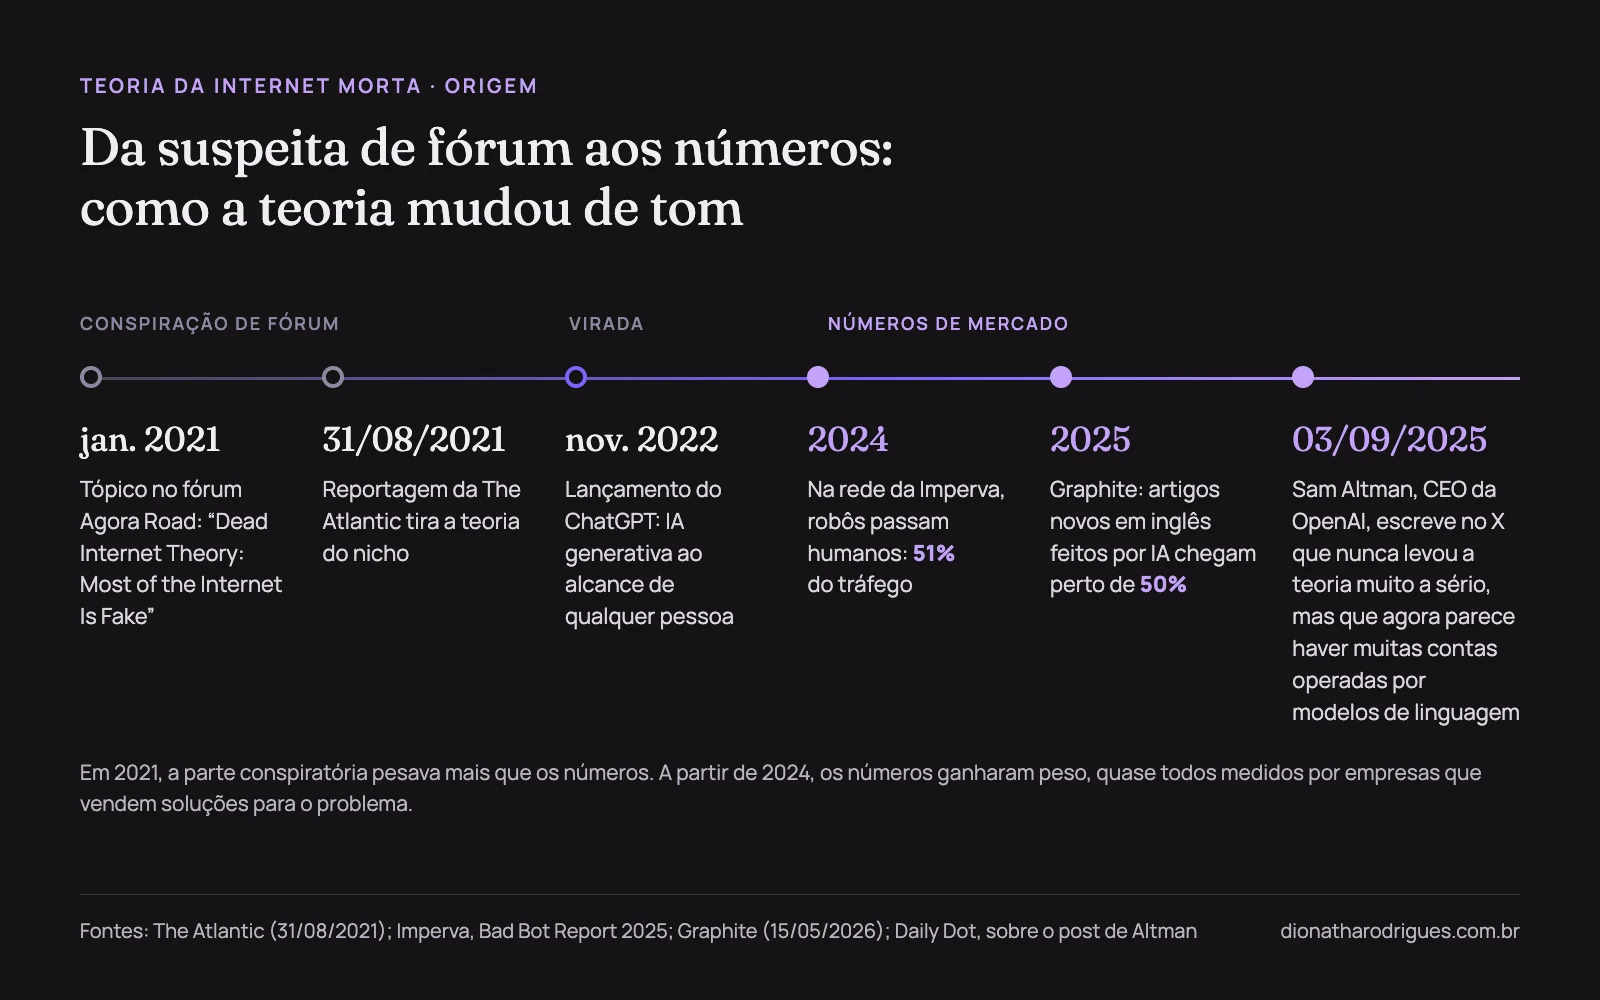
A pergunta parece exagero até a gente olhar os dados recentes. No relatório anual de robôs que a Imperva, empresa de segurança do grupo Thales, publicou em 2026, mais de 53% do tráfego que passou pela rede dela em 2025 veio de robôs. A Graphite, uma agência de SEO, estimou em 2026 que, desde o início de 2025, cerca de metade dos artigos novos em inglês passou a ser escrita principalmente por IA. E em setembro de 2025, Sam Altman, CEO da OpenAI, escreveu no X que nunca tinha levado a Teoria da Internet Morta muito a sério, mas que agora parecia haver muitas contas no Twitter operadas por modelos de linguagem.
Quando quem vende uma das ferramentas que produzem esse conteúdo começa a desconfiar do conteúdo, vale parar e olhar com calma. É o que eu faço neste texto, perseguindo uma pergunta mais antiga que a internet: quando a gente publica, mede e comemora, quem está do outro lado?
O que diz a Teoria da Internet Morta
A teoria ganhou o texto que a popularizou em janeiro de 2021, num tópico do fórum Agora Road’s Macintosh Cafe chamado “Dead Internet Theory: Most of the Internet Is Fake”. A tese tinha duas partes. A primeira: a maior parte do conteúdo e da interação online já seria produzida por robôs. A segunda: isso serviria a um esforço coordenado para influenciar as pessoas.
Ela saiu do nicho em 31 de agosto de 2021, quando a jornalista Kaitlyn Tiffany publicou na The Atlantic a reportagem “Maybe You Missed It, but the Internet ‘Died’ Five Years Ago”. Naquele momento, a parte conspiratória pesava mais que os números, porque ainda não existia IA generativa ao alcance de qualquer pessoa. Isso mudou em pouco mais de um ano, com o lançamento do ChatGPT, e a conversa foi saindo dos fóruns anônimos até chegar ao post de Altman.
Para falar disso sem cair na conspiração, eu uso uma imagem. Imagina um programa de auditório. A plateia aplaude, ri na hora certa e enche o enquadramento. Parte dela, porém, é de figurantes contratados. O aplauso é real, o som é real, mas quem bate palma não comprou ingresso e não vai comprar o produto do patrocinador.
Vou chamar de camada de figurantes todo sinal automatizado que aparece nos seus números como se fosse público: a visita que um robô fez, a impressão que ninguém viu, o clique de um script, o comentário gerado em série, o artigo escrito em escala só para ocupar uma posição de busca. Essa camada sempre existiu. O que mudou foi o custo de produzi-la, que caiu muito com a IA generativa, e a competência com que uma parte dela imita gente.
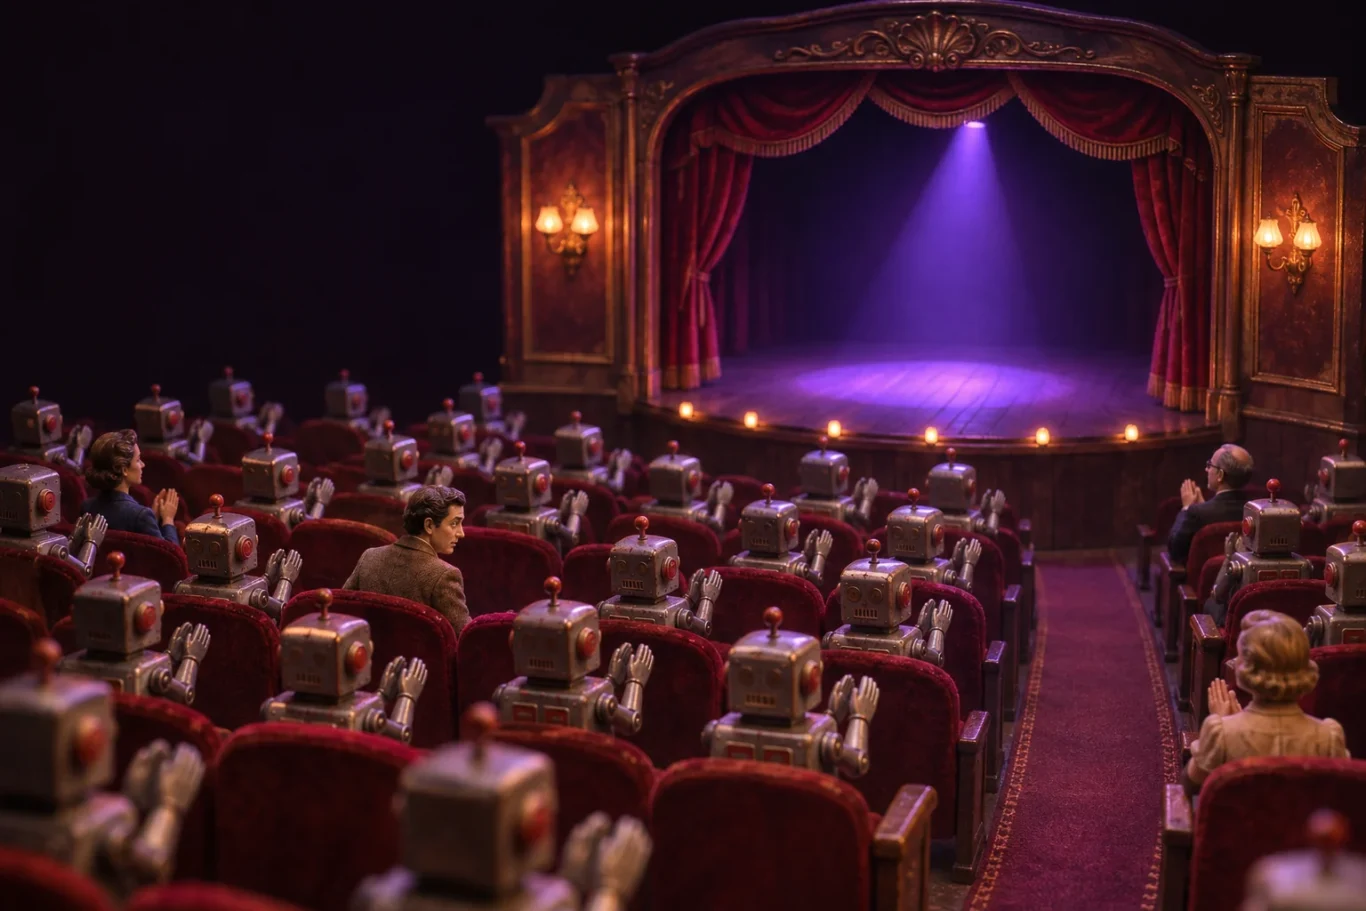
A imagem ajuda porque separa duas perguntas que a teoria mistura. A primeira é quanto da internet é figurante, e essa dá para medir. A segunda é se alguém está coordenando os figurantes para manipular quem ainda é gente, e essa nenhum dos dados que vêm a seguir consegue testar.
O que os números mostram
Não existe um número único para “quanto da internet é robô”. Existem medições diferentes, cada uma olhando um pedaço. Antes de qualquer uma delas, eu faço sempre as mesmas perguntas: quem mediu, em qual rede ou amostra, em que período e o que a empresa vende.
Tráfego: os robôs já passaram os humanos
Pelo relatório da Imperva, o tráfego automatizado passou o humano pela primeira vez em uma década em 2024, com 51% do total, e subiu para mais de 53% em 2025. Os robôs maliciosos, sozinhos, chegaram a 40% de todo o tráfego. O limite é claro: a Imperva vende proteção contra robôs, mede só a própria rede e não detalha a metodologia na página do relatório. É o retrato de uma rede grande; para falar da internet inteira, faltaria um censo que ninguém fez.
Uma segunda rede ajuda a calibrar. No balanço de 2025, a Cloudflare registrou que, em 2 de dezembro, humanos responderam por 47% dos pedidos de página. Os robôs de IA, sem contar o Googlebot, ficaram em média em 4,2% desses pedidos ao longo do ano. As métricas não são iguais às da Imperva, porque uma olha todo o tráfego do ano e a outra só páginas num dia. Nas duas redes, a presença humana fica abaixo da metade dos pedidos medidos. A própria Cloudflare avisa que, contando todos os tipos de arquivo, a proporção muda.
Em 2026, a novidade passou a ser quem são esses robôs. Em setembro, a Cloudflare escreveu que, na rede dela, os pedidos diários de agentes de IA, os programas que navegam e agem em nome de alguém, cresceram mais de 1.700% em um ano. Algumas das categorias mais rastreadas, como varejo, software e TI e serviços financeiros, viram o tráfego humano cair até 40% em menos de um ano. A empresa afirma que, neste ano, pela primeira vez, mais da metade do tráfego que chega aos sites da sua rede foi automatizada, sem detalhar como mediu. Vale o mesmo limite da Imperva: rede própria, de quem vende controle de robôs. A direção dos números é a mesma.
Leitura por IA: muita página lida, pouca visita de volta
Os robôs de IA leem a web para treinar modelos e para responder perguntas. A Cloudflare mediu quantas páginas cada plataforma rastreia para cada visita que devolve aos sites, e a diferença é de outra ordem de grandeza.
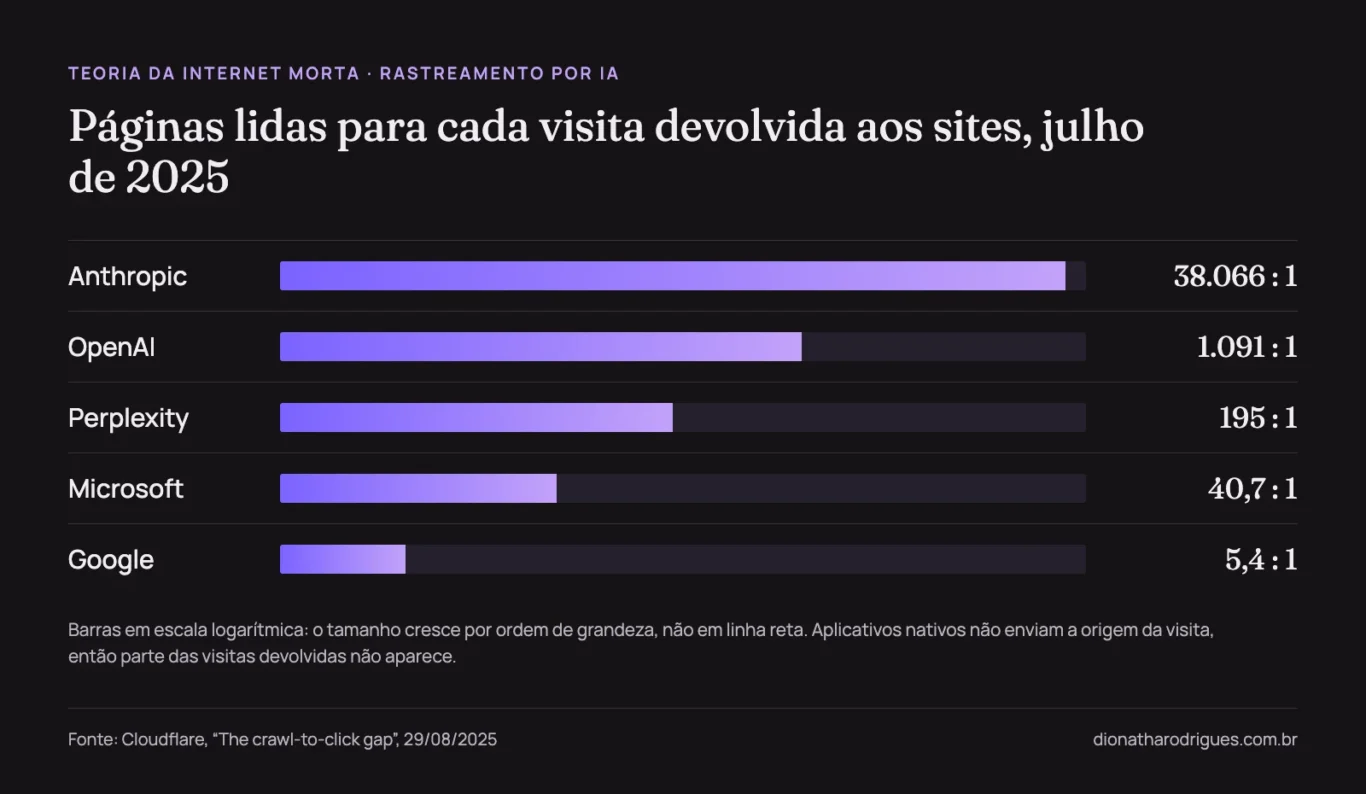
Em julho de 2025, o Google lia cerca de 5 páginas para cada visita devolvida. A Anthropic, mais de 38 mil. Nos 12 meses analisados, 80% do rastreamento por IA servia para treinar modelos. A Cloudflare também ressalta que aplicativos não enviam a origem da visita, então as razões podem estar superestimadas, e as visitas devolvidas foram medidas em sites de notícias clientes dela. A empresa vende ferramentas para controlar esse rastreamento.
Conteúdo: metade do que se publica, bem menos do que se encontra
A Graphite analisou 55,4 mil artigos em inglês tirados do Common Crawl, um arquivo público da web, publicados de janeiro de 2020 a março de 2026. Pela média de três detectores, os artigos feitos principalmente por IA empataram com os humanos desde o início de 2025: 50,9% no último trimestre de 2025. Outras medições chegam a números menores porque olham amostras diferentes. O Pew Research Center, centro de pesquisa independente, encontrou sinais fortes de IA em cerca de 10% das páginas de uma amostra de julho de 2026 e em mais de um terço das publicadas depois do ChatGPT.
Um estudo de outubro de 2026, ainda sem revisão por pares, ajuda a entender por que os números não batem. Adam Visokay e colegas analisaram uma amostra de 5,1 milhões de páginas e estimaram que cerca de 24% das páginas rastreáveis tinham texto gerado ou editado por IA em agosto de 2026, já corrigindo os erros do detector. Com outro recorte e outro critério, a fatia sobe: o rastreador mensal da Originality.ai, que também vende detector, encontrou 45,6% de uma amostra de 2.000 artigos de agosto de 2026 com pelo menos 15% de texto de IA. Página, artigo e post são universos diferentes, e cada número só vale para o seu.
Só que a mesma Graphite, num estudo de outubro de 2025, olhou a outra ponta: o que aparece para quem busca. Ali, 86% dos artigos em inglês que ranqueavam no Google foram classificados como humanos, e 82% dos citados pelo ChatGPT e pelo Perplexity também.
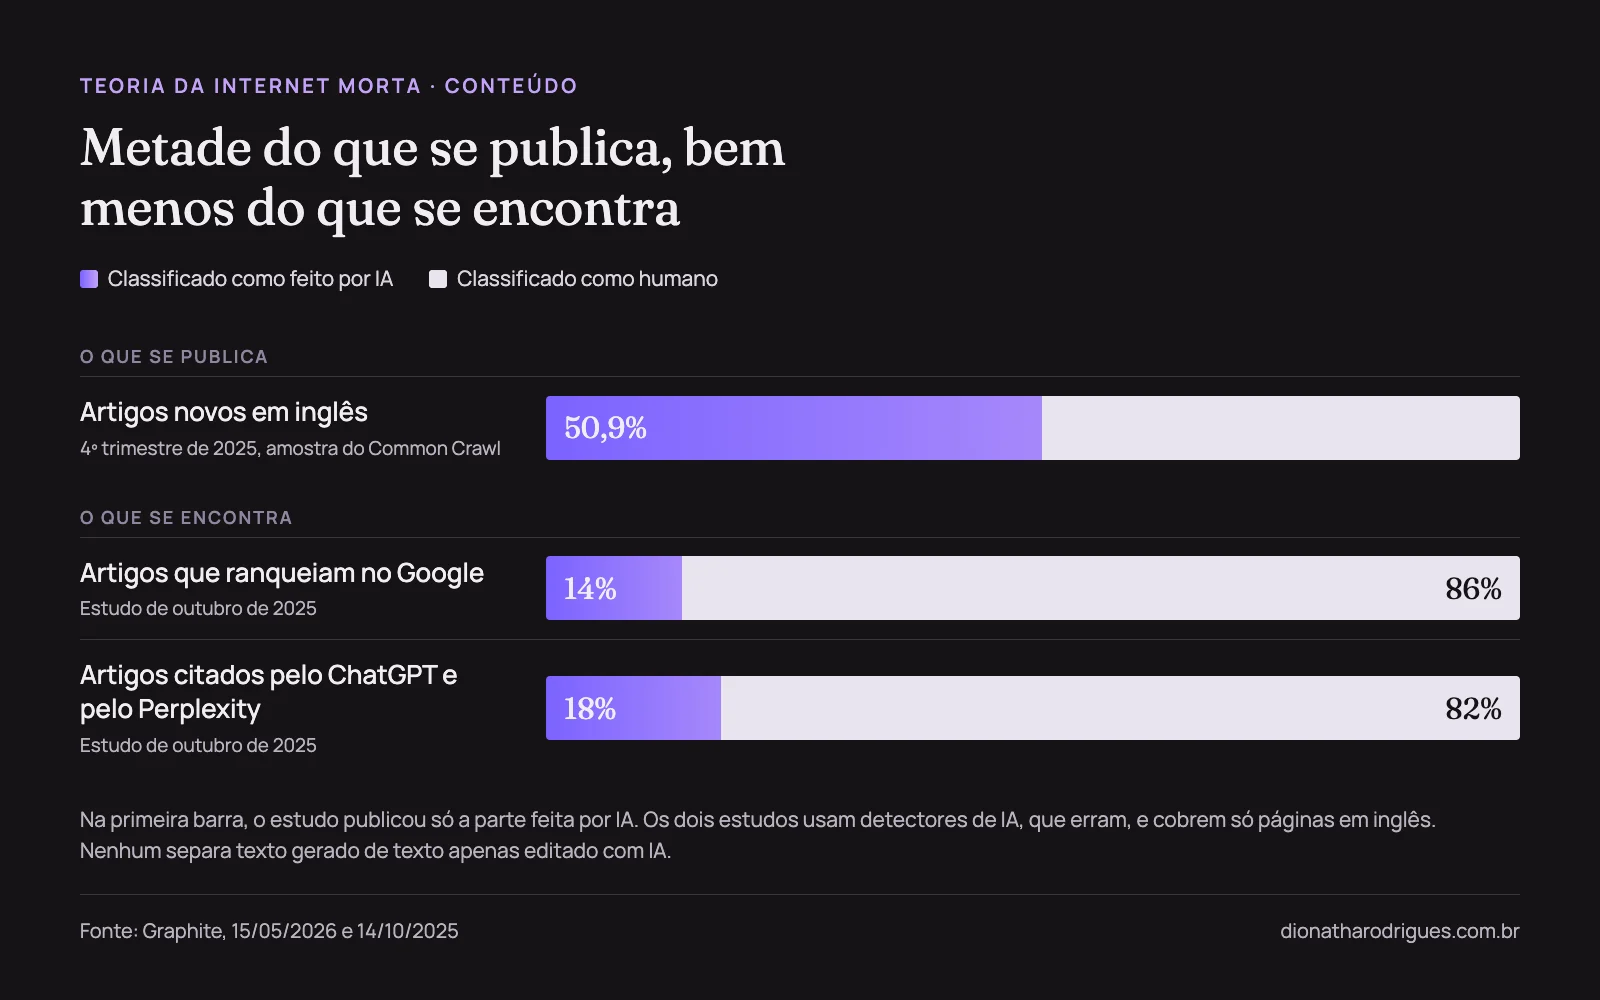
Todos esses números dependem de detectores de IA, que erram, e cobrem só páginas em inglês. Nenhum deles separa texto gerado de texto apenas editado com IA.
Redes sociais: o centro da acusação, os dados mais fracos
A Meta informa ao mercado uma estimativa interna: no último trimestre de 2025, menos de 5% das pessoas ativas por dia nos seus aplicativos eram exclusivamente contas que violam as regras, o que inclui robôs e spam. No mesmo trimestre, diz ter agido contra 1,1 bilhão de contas falsas no Facebook. A Pangram, que vende detector de IA, analisou pouco mais de 1 milhão de posts vistos por usuários da sua extensão de navegador e encontrou uma taxa média de IA de 13,8% nos itens analisados, com mais de 40% dos posts longos no LinkedIn e só 11,6% das postagens principais no Reddit.
E teve o caso que parece roteiro da teoria. Em janeiro de 2025, segundo a CNN, a Meta começou a apagar perfis criados por ela mesma com IA, como “Liv” e “Grandpa Brian”, depois que usuários os redescobriram e a repercussão cresceu. Os perfis existiam, eram operados por IA e conversavam com gente. A diferença para a teoria é que a empresa assumiu a autoria.
Juntando tudo, o padrão é este: os números mais altos de automação, como mais de 53% e cerca de metade, medem o que circula. Os mais baixos, como os 14% de IA no que ranqueia e os menos de 5% de contas irregulares, medem o que chega às pessoas.
Onde a teoria acerta e onde exagera
Começo pelo exagero. Se você já leu algo sobre o assunto, provavelmente encontrou a frase de que 90% do conteúdo online seria gerado por IA até 2026, atribuída à Europol. A origem é um relatório de 2022 do laboratório de inovação da Europol sobre deepfakes, que diz que especialistas estimam esse número. A nota de rodapé que sustenta a frase cita um livro de 2020, de Nina Schick. Uma projeção apoiada num livro virou, de tanto circular, “dado da Europol”. Chegamos a 2026, e as medições de texto em inglês ficam entre cerca de 10% e 50%, conforme a amostra. Para imagem e vídeo, que a Europol também incluía, eu não encontrei medição comparável. A ironia é boa: um dos números mais repetidos sobre a internet morta é ele mesmo um figurante.
Esses dados também não testam a segunda parte da teoria, a da coordenação. Dá para medir figurante; quem contratou todos eles, se é que alguém contratou, fica fora do alcance desses números.
Agora, onde ela acerta. A camada de figurantes cresce por um mecanismo que não precisa de conspiração nenhuma, e ele tem três peças.
A primeira é econômica. Boa parte da web ainda é paga por atenção: impressão, posição de busca, seguidor. Quando produzir uma página, um comentário ou um perfil custa pouco, quem ganha por volume produz mais. O Google reconheceu isso em março de 2024, quando criou a política contra abuso de conteúdo em escala, que vale para muitas páginas feitas para manipular o ranking, “seja o conteúdo produzido por automação, por esforço humano ou por uma combinação”. A palavra para o resultado virou dicionário: “slop”, conteúdo de baixa qualidade produzido em quantidade por IA, foi a palavra do ano de 2025 da Merriam-Webster. O Club Martech tem um checklist para evitar IA slop no dia a dia de quem produz conteúdo, e já discutiu por que produzir mais com IA não significa crescer.
Do lado da regulação, a cobrança começou a chegar: na União Europeia, desde 2 de agosto de 2026, valem as obrigações de transparência do AI Act, acompanhadas de um código de prática sobre marcação e rotulagem de conteúdo gerado por IA.
A segunda peça é que texto humano virou matéria-prima com preço. Um estudo publicado na Nature em julho de 2024, de Ilia Shumailov e colegas, mostrou que modelos treinados de novo e de novo com texto gerado por modelos perdem as partes raras da distribuição e acumulam erros, num experimento com um modelo pequeno. Um trabalho de 2024 ainda em revisão, de Gerstgrasser e colegas, mostrou que acumular dados sintéticos junto com os reais, em vez de substituí-los, evitou o colapso nos cenários testados. Enquanto isso, o mercado já paga por texto escrito por gente: no prospecto de abertura de capital, em fevereiro de 2024, o Reddit declarou contratos de licença de dados que somavam US$ 203 milhões.
A terceira peça é que a leitura da web se separou da visita. Durante duas décadas, o acordo implícito foi este: o buscador lê o seu site e devolve visitas. Com os assistentes, a pessoa recebe a resposta pronta, o site entra como fonte, e a visita, que é onde o marketing mede e converte, nem sempre acontece. O Club Martech aprofunda o que isso muda na jornada de busca com IA.
Os números mais recentes, de duas empresas que vendem medição de tráfego, mostram esse descolamento. Pelo painel da Similarweb, 68% das buscas no Google terminaram sem clique em 2026, numa média que pondera celular e computador. Na rede de sites de notícias medida pela Chartbeat, as visitas vindas do Google Search caíram 34% entre dezembro de 2024 e dezembro de 2025, e, segundo a Chartbeat, num texto sem data, os chatbots de IA somados ainda trazem menos de 1% das visitas. O que eu tiro disso: a leitura continua acontecendo, só que cada vez mais longe do site.
Para quem trabalha com marketing, essas três peças chegam ao funil por quatro portas.
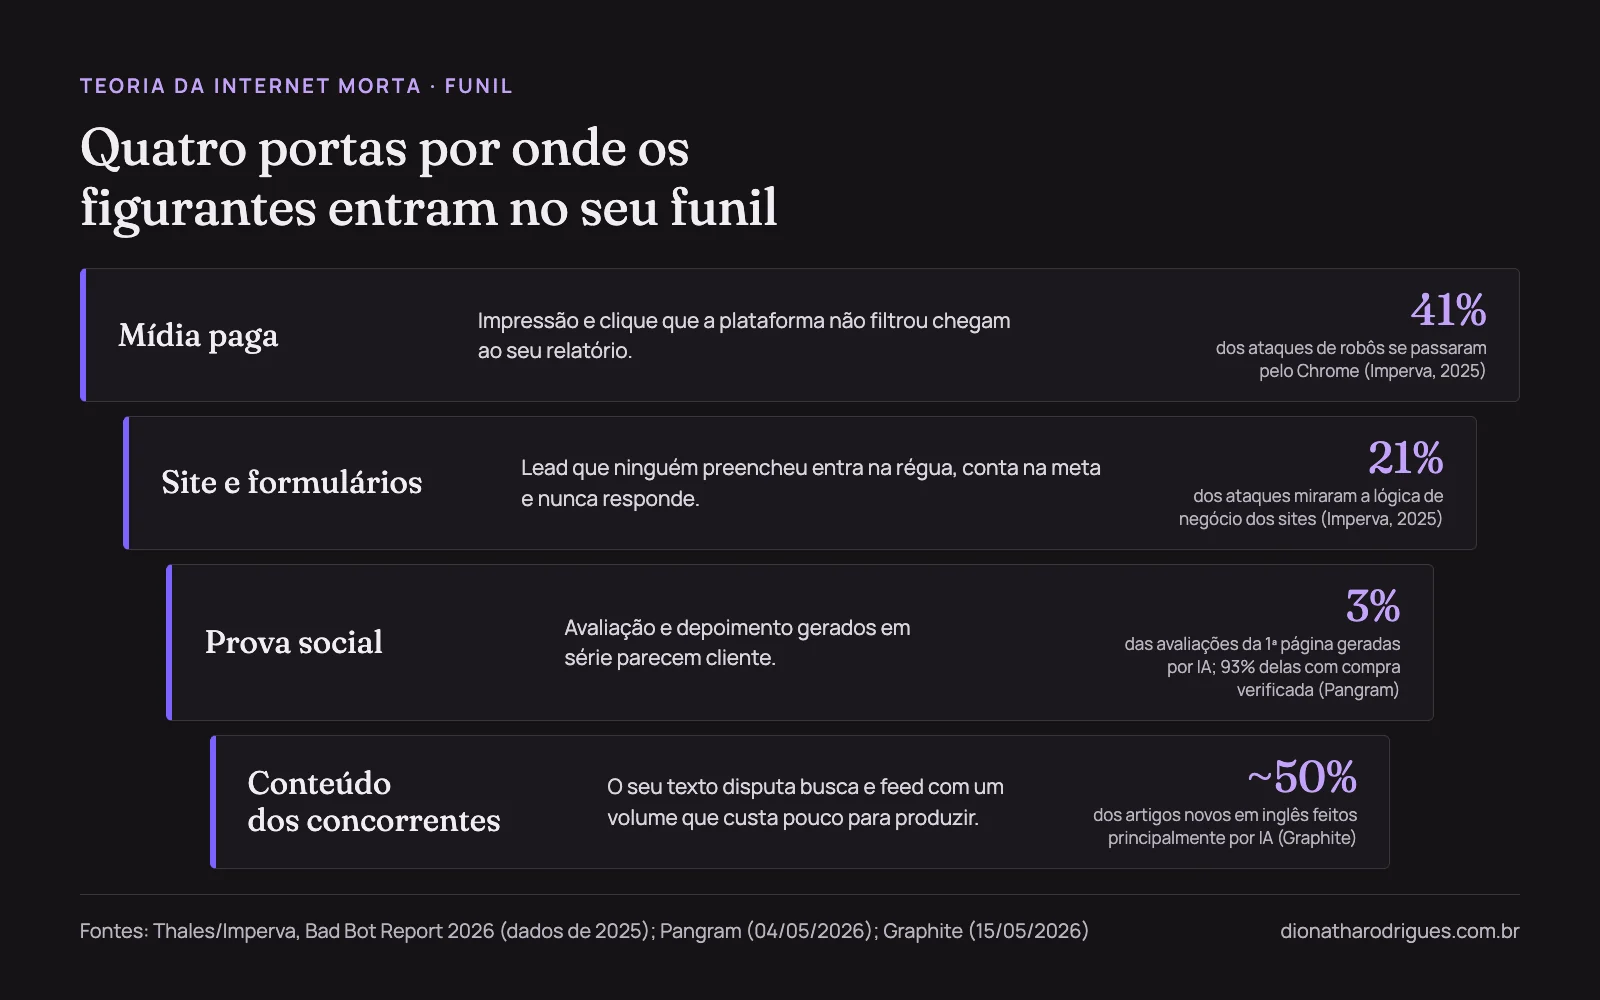
Na mídia paga, o que a plataforma não detecta segue para o relatório, e detectar ficou mais difícil: na rede da Imperva, 41% dos ataques de robôs em 2025 se passaram pelo navegador Chrome. É dado de ataque, medido fora do analytics, mas mostra a técnica. A Meta, por exemplo, oferece as impressões brutas, que incluem o que ela mesma identificou como tráfego inválido; a diferença para as impressões comuns mostra o tamanho do filtro. No site, formulário aberto é porta para lead que ninguém preencheu. Na mesma rede da Imperva, 21% dos ataques de robôs miraram a lógica de negócio dos sites, como cadastro e compra, e a empresa não detalha quanto disso é formulário.
Na prova social, a Pangram classificou 3% das avaliações da primeira página de 500 produtos mais vendidos da Amazon como geradas por IA, e 93% delas tinham selo de compra verificada. A Pangram não informa o período de coleta, então vale usar o número como ordem de grandeza. E, no conteúdo, o seu texto disputa busca e feed com um volume que custa pouco para produzir.
O efeito é mais concreto do que parece. Num exemplo com números inventados só para a conta: uma campanha traz 1.000 leads a R$ 20 cada. Se 15% deles forem automatizados, o custo por lead real sobe para R$ 23,53. Se a meta do trimestre seguinte foi definida em cima dos R$ 20, ela foi definida em cima dos figurantes.
Eu esperaria duas objeções. A primeira é “o Google Analytics já filtra robô”. Filtra os robôs conhecidos, por uma lista, sem deixar ver quanto excluiu; o robô que se passa por navegador comum entra como visita. A segunda é “então o problema é o texto feito com IA”. Os dados não dizem isso: um estudo com dados do Internet Archive não encontrou queda significativa de precisão factual nos sites com mais texto de IA, mas encontrou menos variedade de ideias. E a política do Google não proíbe texto com IA; ela pune volume feito para manipular, venha de máquina ou de gente.
A pergunta por trás dos números: quem está do outro lado?
Até aqui eu tratei a camada de figurantes como problema de medição, e ela é. Mas, depois de juntar esses números, o que mais me ocupou a cabeça foi outra coisa. A internet sempre funcionou com uma confiança que ninguém precisava dizer em voz alta: a de que, do outro lado da tela, havia alguém. A Teoria da Internet Morta incomoda porque mexe justamente nessa confiança. E outra confiança, vizinha dessa, também está baixa: numa pesquisa da AP-NORC feita nos EUA entre julho e agosto de 2026, só 9% dos adultos disseram ter muita ou total confiança de que a informação de IA, chatbots ou resultados de busca é confiável e factual, e 49% disseram ter pouca ou nenhuma.
O jogo da imitação virou rotina
Em 1950, o matemático Alan Turing publicou na revista Mind o artigo “Computing Machinery and Intelligence”. Em vez de discutir se uma máquina pensa, ele propôs um teste: uma pessoa conversa por texto com dois interlocutores escondidos, um humano e uma máquina, e tenta descobrir quem é quem. Ele chamou isso de jogo da imitação.
Turing imaginou um experimento, com juiz avisado e tempo contado. Hoje a gente joga o tempo todo, sem aviso. Cada comentário, cada avaliação de produto e cada lead que chega no CRM é uma rodada em que alguém precisa decidir se tem gente do outro lado. E a pergunta trocou de lugar: Turing queria saber se a máquina passaria por humana; quem trabalha com marketing precisa saber se o humano que aparece no relatório existe.
O que isso me faz pensar é que o trabalho de quem opera marketing ganhou um papel que ninguém colocou na descrição do cargo, o de juiz desse jogo. E juiz que não sabe que está julgando tende a aceitar quase tudo.
Quando a métrica vira meta, alguém aprende a fabricá-la
Em 1975, o economista Charles Goodhart, analisando a política monetária britânica, observou que uma regularidade estatística tende a desmoronar quando passa a ser pressionada para fins de controle. A formulação que ficou famosa é da antropóloga Marilyn Strathern, num artigo de 1997 sobre a avaliação das universidades britânicas: quando uma medida vira meta, ela deixa de ser uma boa medida. É a chamada lei de Goodhart.
Minha leitura é que a camada de figurantes é a lei de Goodhart em escala industrial. Seguidor, visualização, avaliação e posição de busca viraram meta de alguém, e onde existe meta paga existe incentivo para fabricar o número sem fabricar aquilo que ele deveria medir. Para isso acontecer, basta uma régua que paga por clique e alguém disposto a produzir cliques mais baratos que os de gente.
O que o figurante não entrega: atenção
Em 1971, o pesquisador Herbert Simon, que ganharia o Nobel de Economia em 1978, escreveu que a informação consome a atenção de quem a recebe e que, por isso, a abundância de informação produz escassez de atenção. A ideia está no ensaio “Designing Organizations for an Information-Rich World”. Simon pensava em organizações, como empresas e órgãos de governo, e nos computadores da época. Mesmo assim, ela descreve bem o momento.
Se produzir conteúdo ficou barato, o custo maior fica com quem recebe, como Simon já apontava em 1971, e o conteúdo deixa de ser o recurso escasso. O escasso agora é a atenção de alguém real, que é justamente o que um figurante não consegue entregar. Um robô consegue abrir a página, clicar, comentar e preencher formulário. Prestar atenção, mudar de ideia e lembrar da sua marca na semana seguinte continuam sendo coisas de gente.
Existe ainda uma leitura que inverte a teoria. Em 2019, o empreendedor Yancey Strickler, cofundador e ex-CEO do Kickstarter, escreveu “The Dark Forest Theory of the Internet”, inspirado no romance de ficção científica de Liu Cixin. A ideia: o espaço aberto da internet ficou parecido com uma floresta escura à noite, cheia de anúncios, rastreamento e trolls, e as pessoas foram para lugares menores e mais fechados, como newsletters, podcasts e grupos. Se ele estiver certo, uma parte das pessoas continua aqui, só que fora da sala onde as métricas olham.
Juntando essas ideias, a minha leitura fica assim. A teoria exagera quando diz que a internet morreu, mas acerta ao lembrar que a presença de alguém do outro lado sempre foi uma suposição. E, no marketing, uma suposição pode virar meta sem que ninguém confira.
E qual é o nosso papel nisso?
Aqui vem a parte desconfortável, e eu me incluo nela. A camada de figurantes acontece com o marketing, e a minha leitura é que uma parte dela também é feita por marketing.
Na minha leitura, quando a política do Google contra abuso de escala vale para conteúdo produzido “por automação, por esforço humano ou por uma combinação”, ela descreve uma prática que já existia nas pautas de SEO antes da IA generativa: o texto feito em volume para ocupar posição. Quando a palavra do ano vira “slop”, ela fala de texto que alguém decidiu publicar. E quando a meta do trimestre é volume de lead, de seguidor ou de visualização, o raciocínio da lei de Goodhart sugere que alguém vai encontrar um jeito mais barato de entregar o número, um problema de desenho de meta que a operação de marketing existe para resolver. Às vezes esse alguém somos nós mesmos, com a melhor das intenções e uma ferramenta nova na mão.
Por isso, para mim, é pouco tratar o assunto só como defesa: filtrar robô, bloquear rastreador, limpar o CRM. Tudo isso importa, e tem custo. Mas a escolha que mais pesa vem antes, quando a gente decide o que conta como resultado, o que vale a pena publicar e para quem estamos, de fato, escrevendo.
Se a internet ficar cheia de figurantes, vai ser também porque a gente paga por eles e os conta como resultado. Então eu deixo a pergunta que me fiz ao terminar este texto: no próximo número que você apresentar como resultado, quantas pessoas de verdade estão por trás dele? E, se você não souber responder, o que isso diz sobre o trabalho que a gente escolheu fazer?
Fontes
- Origem: Kaitlyn Tiffany, Maybe You Missed It, but the Internet ‘Died’ Five Years Ago, The Atlantic (31/08/2021); o tópico do fórum Agora Road e o post de Sam Altman no X (03/09/2025) foram conferidos em fontes secundárias, como Daily Dot.
- Thales/Imperva, Bad Bot Report 2026 (dados de 2025) e post de 30/04/2026. Fornecedor de proteção contra robôs. Resumo no blog da Imperva (29/04/2026): “mais de 53%” em 2025.
- Imperva, Bad Bot Report 2025 (15/04/2025).
- Cloudflare Radar, 2025 Year in Review (dados de 01/01 a 02/12/2025). Fornecedor de rede e segurança.
- Cloudflare, The crawl-to-click gap (29/08/2025). Fornecedor de controle de rastreamento por IA.
- Graphite, AI now writes as many online articles as humans do (15/05/2026). Agência de SEO.
- Graphite, AI content in search and LLMs (14/10/2025).
- Pew Research Center, How Much of the Internet Is Written With AI? (20/08/2026). Centro de pesquisa independente.
- Dolezal, Alam, Graham e Bohacek, The Impact of AI-Generated Text on the Internet (preprint, 14/04/2026). Acadêmico.
- Meta Platforms, relatório anual 10-K do exercício de 2025 (29/01/2026) e relatório ao Code of Practice on Disinformation (2º semestre de 2025). A própria empresa.
- Pangram, AI in your feed (09/07/2026). Fornecedor de detector de IA, amostra de usuários da extensão.
- Pangram, Three percent of front-page Amazon reviews are now AI-generated (página datada de 04/05/2026; período de coleta não informado). Fornecedor de detector de IA.
- CNN, Meta scrambles to delete its own AI accounts (03/01/2025). Imprensa; lida na republicação da RNZ.
- Europol Innovation Lab, Facing reality? Law enforcement and the challenge of deepfakes (2022). A nota 4 cita Nina Schick, Deepfakes: The Coming Infocalypse (2020).
- Google Search Central, políticas de spam e anúncio de 05/03/2024.
- Ajuda do Google Analytics, exclusão de tráfego de robôs conhecidos. Documentação da empresa.
- Central de Ajuda da Meta, impressões brutas (documentação da empresa).
- Shumailov et al., AI models collapse when trained on recursively generated data, Nature (24/07/2024, acadêmico) e Gerstgrasser et al., Is Model Collapse Inevitable? (preprint, 2024).
- Reddit, prospecto S-1 (22/02/2024).
- AP, Merriam-Webster escolhe “slop” como palavra do ano de 2025 (15/12/2025).
- Alan M. Turing, Computing Machinery and Intelligence, Mind, v. 59, n. 236 (outubro de 1950). Acadêmico.
- Charles Goodhart, Problems of Monetary Management: The U.K. Experience, apresentado em conferência do Reserve Bank of Australia em julho de 1975 e publicado em Papers in Monetary Economics, v. 1 (1976), obra impressa sem versão aberta oficial; Marilyn Strathern, ‘Improving ratings’: audit in the British University system, European Review, v. 5, n. 3 (1997). Acadêmico.
- Herbert A. Simon, Designing Organizations for an Information-Rich World, em Martin Greenberger (org.), Computers, Communications, and the Public Interest, Johns Hopkins Press (1971), obra impressa sem versão aberta oficial. Acadêmico.
- OpenAI, Introducing ChatGPT (30/11/2022). A própria empresa.
- Cloudflare, The Internet has a second audience (30/09/2026). Fornecedor de rede e controle de robôs; dados da própria rede.
- Visokay et al., The uneven rise of AI-generated web content (preprint, 27/10/2026). Acadêmico, sem revisão por pares.
- Originality.ai, Dead Internet Tracker de agosto (01/10/2026). Fornecedor de detector de IA; 2.000 artigos de 500 palavras ou mais do Common Crawl.
- Similarweb, zero-click marketing (10/06/2026). Fornecedor de inteligência de tráfego; painel de clickstream.
- Chartbeat, Pageviews are down, but AI’s impact is complicated (sem data na página; republicado do INMA). Fornecedor de analytics; rede de sites de notícias.
- AP-NORC, State of the Facts 2026 (09/09/2026). Pesquisa de opinião com 1.036 adultos dos EUA, margem de ±4,1 pontos.
- Comissão Europeia, código de prática para marcação e rotulagem de conteúdo gerado por IA (10/06/2026). Fonte oficial.
- Yancey Strickler, The Dark Forest Theory of the Internet (26/05/2019). Ensaio.
Fontes conferidas em 10/11/2026 e 11/11/2026; as fontes de 2026 foram abertas uma a uma em 11/11/2026. Lidas só em fontes secundárias ou republicação: o tópico do Agora Road, o post de Altman e a CNN. Lidos só pelo resumo: Gerstgrasser e o estudo com dados do Internet Archive. As obras de Turing, Goodhart, Strathern e Simon aparecem em paráfrase; as passagens de Strathern (p. 308) e Simon (p. 40–41) foram conferidas em cópia digitalizada, e a de Goodhart, em fontes secundárias (11/11/2026).